





この記事で分かること
- 生成AIコーディング支援で使われる主な機能と、開発工程ごとの向き不向き
- 作業の速さや理解を助けるメリットと、見落としやすい失敗要因
- 機密情報、権限、レビュー、テスト、依存ライブラリを守る実務上のルール
- 小さく試し、品質を測りながら利用範囲を広げる手順
生成AIの開発支援は、機能ごとに役割が異なる
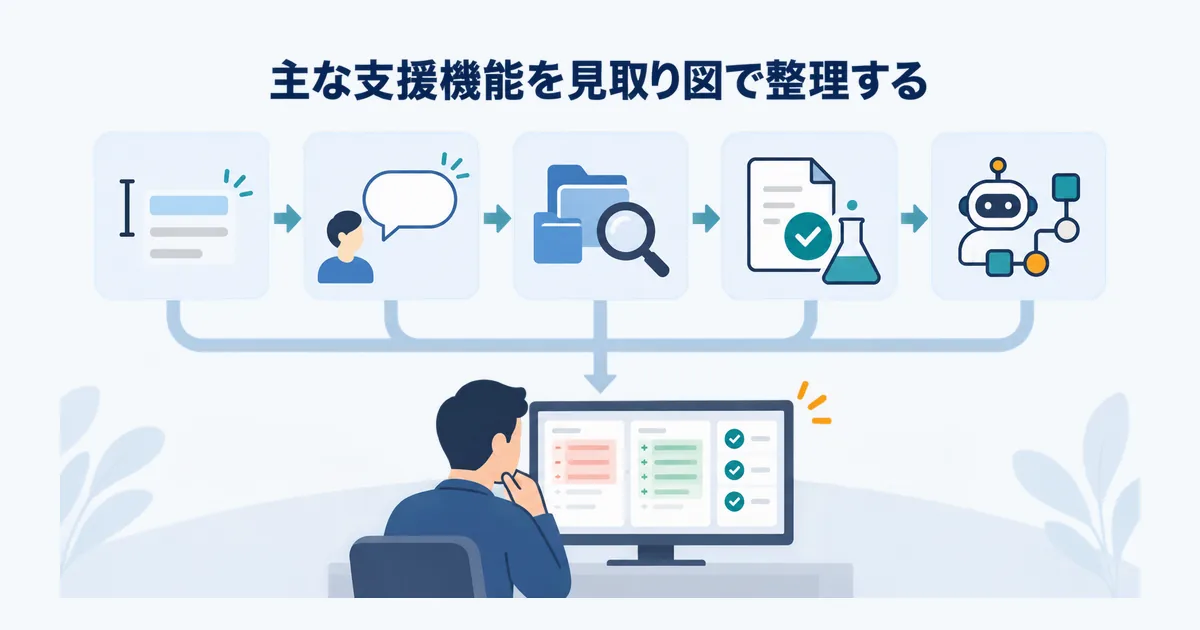
主な支援機能を見取り図で整理する
「生成AIツール」と一括りにしても、エディターに表示される入力補完、質問に答えるチャット、リポジトリ内を探す機能、複数ファイルを編集するエージェントでは、扱う情報と実行できる操作が異なります。機能名が似ていても、どのファイルを参照するか、コマンドを実行できるか、変更をどこへ保存するかは製品や設定で変わります。導入前には、宣伝上の呼称よりも、実際の入力・出力・実行権限を確認してください。
| 機能の種類 | よく使う場面 | 人が押さえる点 |
|---|---|---|
| コード補完 | 入力中の定型処理、型や関数の候補、コメントからの短い実装案 | 前後の処理と例外条件を読み、必要な部分だけ採用する |
| チャット | エラーの説明、設計案の比較、特定コードの読み解き、テスト観点の相談 | 質問へ渡したコードや会話の前提が回答に使われることを意識する |
| コードベース検索・文脈参照 | 関連する画面、API、データ処理、設定ファイルの所在を探す | 検索結果の漏れや古い情報を補い、実際の定義元を確認する |
| 複数ファイルの編集・テスト補助 | 変更案、テストコード、ドキュメント、移行作業の下書きを作る | 差分を分割し、実行結果と既存動作への影響を確かめる |
| エージェント・レビュー支援 | 手順を分けた作業、修正候補の提示、プルリクエストの確認補助 | ツールに許可した操作範囲と、最終判断を行う担当者を決める |
GitHub Copilotの公式資料では、IDEでのコード候補、チャットによる質問、エージェントによるファイル編集やコマンド実行、プルリクエストのレビューなどが別々の機能として案内されています。これは一製品の説明であり、すべての生成AIツールが同じ機能・設定を持つという意味ではありません。自社が採用するサービスの管理画面や公式ガイドを読み、契約プランや利用環境で有効な機能を確認しましょう。
活用のメリットは、考える時間と反復作業を減らせること
生成AIを使う利点は、開発全体を自動化することよりも、手を動かす前後の小さな待ち時間を減らすところにあります。実装の候補を早く得られれば、担当者は要件の確認や設計判断、利用者との調整に時間を回せます。ただし、短くなった作業時間がそのまま納期短縮や品質向上になるとは限りません。受け入れ確認や修正の時間を含め、チームで実際の効果を記録する必要があります。
生産性の効果は、ツールの世代や開発者、作業内容、コードベースによって変わり、一律には言えません。METRが初期2025年のAIツールを対象に実施した無作為化比較試験では、よく知る大規模なオープンソース案件に取り組む経験豊富な開発者16名、246課題という条件で、AI利用時の完了時間が平均19%長くなりました。METRの後続調査は、後期2025年のツールで小幅な短縮を示す推定値も報告していますが、参加者や提出課題の選び方に偏りがあり、時間の測り方にも限界があるため、効果の大きさを示す確かな値とはしていません。どちらの結果も、個々の現場での効果を代わりに予測するものではありません。準備・確認・修正まで含む所要時間を、自社の実作業で測ってください。
定型的な実装や文書を、初稿から始められる
入力チェック、データ変換、APIの呼び出し例、SQLの素案、簡単なテストケースなどは、求める条件を具体的に説明できれば、空の状態から書き始める負担を軽くできます。既存の命名規則やエラー処理の例を一緒に示すと、プロジェクトの書き方に近い案を得やすくなります。生成結果は完成品とせず、差分の一案として比較してください。短い処理でも、境界値、権限、失敗時の動きは別途見直します。
初めて触るコードの調査を始めやすくする
引き継いだシステムでは、どの画面から処理が始まるか、値がどこで保存されるか、同じ業務ルールが何か所に実装されているかを追うのに時間がかかります。コードベースを参照するチャットや検索機能は、調査の入口となるファイルや関係しそうな処理を挙げ、担当者の確認範囲を絞る助けになります。ただし、参照できる範囲や検索の精度は設定と索引の状態に左右されます。回答に示されたファイル名・関数名を実際のソースと照合し、見つからなかった箇所を「存在しない」と早合点しないでください。システムの改修や再構築の進め方に迷う場合は、既存システムの開発前診断のように現状を整理する選択肢もあります。
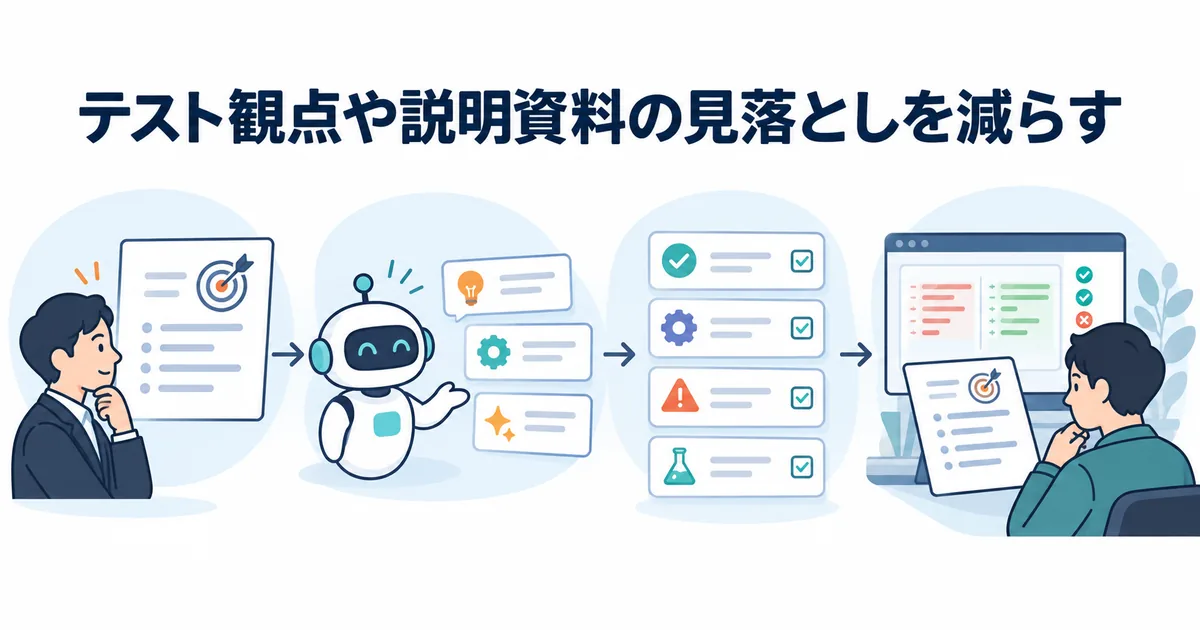
テスト観点や説明資料の見落としを減らす
変更内容からテストケースのたたき台を作らせたり、仕様書の抜けを質問したりすることで、自分だけでは思いつかなかった条件に気づく場合があります。担当者が先に受け入れ条件を整理し、それをもとにAIへ「正常系だけでなく、空値、重複、権限不足、通信失敗の場合も候補を出す」と依頼すると、確認に使える一覧を作りやすくなります。候補はチェックリストの出発点です。業務上の重要度や実際の利用状況に照らして、必要な試験を人が選び、実行して記録します。
また、変更の要約やレビュー依頼文の下書きを用意すれば、レビュー担当者へ意図を伝える準備が進みます。AIに説明文を作らせても、変更の理由・影響範囲・未対応事項が正確かどうかは、実装者が差分を読んで確かめましょう。たとえばコードの変更を加えていない機能まで「改善済み」と書けば、後工程の判断を誤らせる恐れがあります。
AIを含むシステム自体を企画する場合は、コーディング支援の使い方に加え、利用目的やデータ、評価方法の設計が必要です。生成AIシステムの違い・用途・リスクも、要件を考えるときの参考になります。
失敗を招くのは、もっともらしい出力を検証済みと扱うこと
生成AIは、質問や周辺のコードから妥当そうな答えを組み立てます。そのため、構文が整ったコードや筋が通った説明であっても、業務要件に沿うとは限りません。チームが警戒すべきなのは、目立つエラーだけではなく、「一見動くが、条件が変わると間違える」変更です。次のような失敗は、単にモデルの誤答というより、前提の不足や受け入れ工程の不備と重なって起きます。
- 業務ルールの取り違え:コードには書かれていない例外、締め処理、承認条件を知らないまま、一般的な実装案を返すことがあります。要件や仕様が曖昧なら、先に業務担当者へ確認します。
- 古い情報や存在しないAPI:学習時期や会話に含まれた情報だけでは、採用中のライブラリ版や社内の独自仕様を特定できない場合があります。公式リファレンス、ロックファイル、型定義と照合します。
- 周辺影響の見落とし:依頼されたファイルだけを修正し、他の呼び出し元、既存データ、運用手順との整合を崩すことがあります。変更前に影響範囲を列挙し、差分を小さく保ちます。
- 弱いテストでの安心:生成したテストが実装の間違いをそのまま前提にしていると、誤った動作を正しいと判定することがあります。期待する動作をテストコードとは別に定義します。
- 過剰な修正や削除:エージェントに「直して」とだけ依頼すると、変更の目的を超えた書き換え、テストの削除、設定の変更が含まれることがあります。変更箇所を見て、依頼外の差分は理由を確認します。
GitHubの公式レビュー資料も、生成コードの意図・設計との適合、動作確認、静的解析、依存パッケージの実在性や保守状況、ライセンス、脆弱性などの確認を案内しています。製品側のレビュー機能を使っても、そこで指摘されなかったことは無欠陥の証明になりません。既存の人間レビューやCIを置き換えず、確認材料を増やす役割として組み込みます。
機密情報と権限は、ツールの利用前に決める
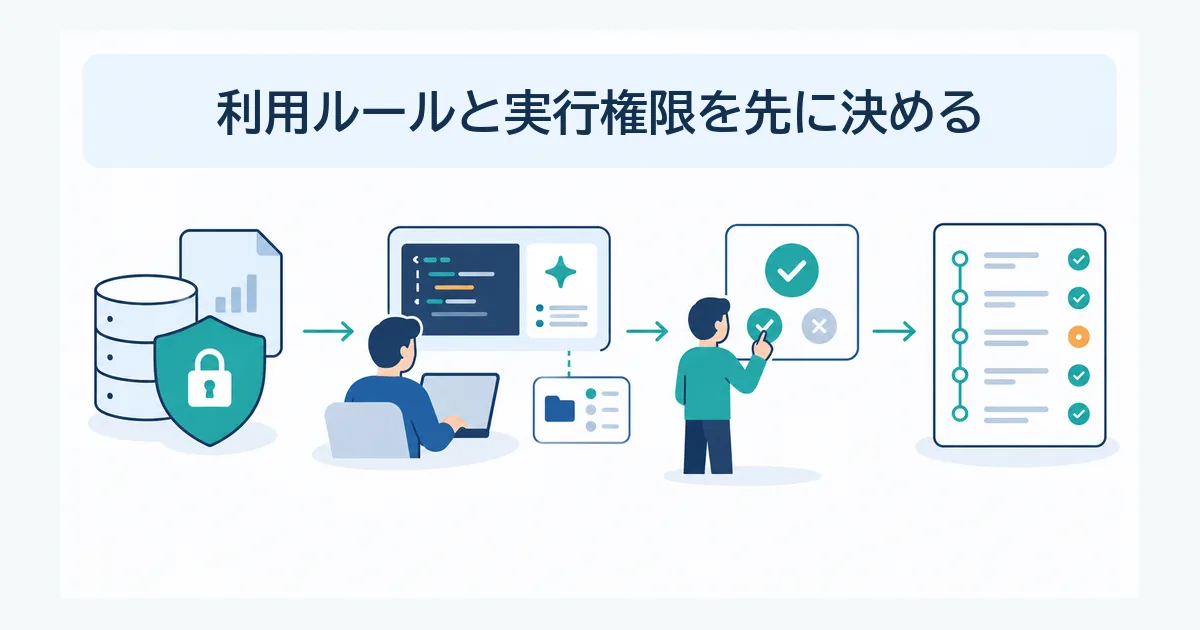
利用ルールと実行権限を先に決める
コードや質問をクラウド型サービスへ渡すか、どのモデルへ処理を委ねるか、入力・出力がどのように保持されるかは、製品、契約、設定によって異なります。「法人契約だから送信されない」「ローカルエディターだから外へ出ない」といった思い込みで判断せず、利用する機能ごとに公式のデータ取扱説明、管理者設定、契約条件を確認します。開発チームには、守るべき情報の具体例と、利用可否を判断する窓口を周知してください。
少なくとも、認証情報、秘密鍵、アクセストークン、本番の個人データ、顧客との非公開契約内容を、承認されていないチャットやプロンプトへ貼り付けないルールを設けます。画面上で伏字にしても、選択範囲や添付ファイル、IDEが参照する開いたファイルに同じ情報が含まれている可能性があります。機密のコードを使う必要があるときは、組織が承認したサービスと設定で処理できるか、情報システム・セキュリティ担当に確認します。匿名化や最小化ができる作業は、実データを渡さずに行います。
権限を持つエージェントでは、閲覧だけの質問と、ファイル編集、シェル実行、ネットワーク接続、コミットやプルリクエスト作成を区別します。必要なリポジトリとブランチだけにアクセスを絞り、承認なしに本番環境へ接続したり、不可逆な操作を実行したりしない構成にします。コマンド実行を許可する場合は、実行前の確認、実行ログ、停止手段、作業用環境を用意します。自動化を一度に広げず、まず読み取りや下書きなど影響の小さい権限から始めましょう。
生成AIのリスク管理は、モデルだけを見ても十分ではありません。利用目的、利用者、入力データ、周囲の業務・システム、評価と監視まで含めて考えます。NISTの生成AI向けリスク管理プロファイルは、組織の目的やリスク許容度に応じたガバナンス、把握、測定、管理を示しています。実務では、社内の利用規程を開発工程に結び付け、いつ誰が承認するかを明記すると扱いやすくなります。
レビューとテストの責任者を明確にする
AIが作成したコードをコミットする人、レビューを承認する人、リリースを判断する人を決めておきます。作業をエージェントへ割り当てても、成果物の所有者は曖昧になりません。開発者は要求と差分の対応関係を説明できる状態にし、レビュアーはAI出力かどうかだけで評価せず、通常の変更と同じ品質基準で確認します。特に、認証・認可、個人情報、金額計算、外部入力、データ削除、監査ログなど、失敗時の影響が大きい処理は専門担当者の確認を加えます。
レビューを助けるため、プルリクエストには次の情報を含めます。AIへの指示文そのものを提出する必要はありませんが、生成コードであることを申告する社内ルールを設ける場合は、記録の目的と保存範囲を決めてから運用します。
- 解決する課題と、受け入れ条件
- 変更した機能・データ・設定と、影響が及びそうな箇所
- 実行したテスト、静的解析、セキュリティ確認とその結果
- 新しい依存関係、その採用理由、ライセンスと保守状況の確認結果
- 未確認の前提、残っているリスク、戻し方
テストでは、AIに追加させたテストだけでなく、要件から独立して作った期待値、既存の回帰テスト、統合・受け入れ試験を組み合わせます。失敗したテストは理由を調べ、テストを無効化・削除して通すのではなく、要件または実装のどちらに誤りがあるかを確かめます。修正後は、差分に関係するテストだけでなく、影響範囲に応じて全体のテストやビルドも実行し、環境や依存の違いが本番で問題にならないかを見ます。テストが通ったことは、試験した条件で結果が合ったという意味であり、未試験の条件やセキュリティを保証するものではありません。
プロジェクトごとに、レビュー必須の変更、追加で必要な試験、例外申請の経路を決めると、担当者ごとの判断のばらつきを抑えられます。AIシステム開発のPoCチェック項目も、試作段階で評価条件を具体化する際に役立ちます。
ライセンスと依存パッケージを、提案の採用前に調べる
AIが提示したコードやパッケージ名を、出典や利用条件を確認せず採用することは避けます。生成されたコードは、存在しない関数やパッケージ、保守されていない依存、プロジェクトのライセンスと両立しない利用条件を含む可能性があります。必要なパッケージが公式レジストリに存在するか、配布元や保守状況が信頼できるか、脆弱性情報がないかを確認し、採用する版をロックファイルへ記録してください。依存を増やすと、更新や脆弱性対応といった継続的な管理も増えます。
コードの類似やライセンスに関する支援機能が製品にある場合も、対象となるソースや検出方式、利用プラン、設定を確認します。検出機能があることだけで、あらゆる権利上の問題が解消すると判断してはいけません。必要に応じて、コードの出所、既存ライセンス、社内のOSS利用方針を担当者が確認します。疑義が残るコードは、独自に書き直すか、権利関係を確認できる形で採用判断を記録します。
失敗しにくい導入は、小さな対象で効果と手戻りを測る
全社の開発工程に一斉導入する前に、適用範囲を限定した試行から始めます。例えば、機密情報を含まない社内ツールのテスト案作成、ドキュメントの要約、定型コードの補助など、結果を人が確かめやすい作業を選びます。重要な業務ロジックや本番データに接する変更は、実績と管理体制が整うまで対象から外すか、専門レビューを必須にします。
- 目的を決める:何を速くするのか、どの品質指標を守るのかを定義します。「AIを使った回数」ではなく、作業時間、差し戻し、欠陥、レビュー時間などの変化を見ます。
- 利用条件を決める:承認済みのサービス、利用可能な情報、禁止する情報、保存・共有の設定、問い合わせ先を明文化します。
- 人の確認点を決める:提案の確認、テスト、コードレビュー、リリース判断の担当者と、エージェントに許す操作を定めます。
- 範囲を絞って試す:対象の作業、参加者、期間を限定し、導入前と導入後で同じ条件に近い比較を行います。
- 結果を見直す:時間短縮だけでなく、修正回数やレビュー負荷、セキュリティ上の逸脱も見て、ルールと対象を調整します。
評価では、AI利用による時間短縮を実感だけで結論付けず、準備・確認・修正を含めた所要時間を見ます。候補生成に数分かかっても、誤りを直す時間が増えれば作業全体は短くなりません。比較する際は、作業の難しさや担当者の経験が違うと結果も変わることに留意します。測定値は改善の手がかりであり、特定のチームで得た効果を他の案件にもそのまま当てはめないようにします。
社内の利用ガイドには、良い依頼文の例だけでなく、情報を貼り付ける前の確認、差分の読み方、テストの再実行、依存を追加する際の申請方法などを含めます。個人のプロンプト技術に依存させず、リポジトリの規約やレビュー手順にも必要な基準を置けば、担当者が変わっても一定の手順で作業できます。
AI開発の相談窓口や開発体制を検討している場合は、AIシステム開発のサービス内容を確認できます。構想や既存システムの状態から整理したいときは、生成AIシステム開発のリスク管理も参考にしてください。
AIに任せる範囲は、影響と検証しやすさで決める
生成AIをどの工程で使うかは、作業の面白さや新しさではなく、間違えた場合の影響と、正しさを確かめる手段があるかで判断します。初稿を人が簡単に確認でき、誤りを元に戻しやすい作業は試しやすい一方、顧客データや本番操作を扱う作業は権限と責任を明確にし、限定した環境で検証する必要があります。次の表は、使い始めるときの整理例です。個別の製品や開発環境に合わせて基準を調整してください。
| 作業の例 | 始め方の目安 | 確認のしかた |
|---|---|---|
| 公開情報を使った調査メモや文章の下書き | 人が内容を確認してから利用 | 参照元、事実関係、社外秘の混入を確かめる |
| 定型的なテスト案や小さな関数の候補 | 開発者の環境で試行し、レビュー後に採用 | 要件との対応、境界値、回帰テスト、規約を確認 |
| 複数ファイルを変更するエージェント作業 | 作業ブランチと限定した権限で実施 | 全差分、コマンド、設定、生成された依存を確認 |
| 認証・個人情報・金銭・本番環境に影響する変更 | 承認済み環境と専門担当者の監督下に限定 | セキュリティ・業務レビュー、試験、戻し方を確認 |
「AIが書いたから危険」「AIが作ったテストが通ったから安心」のどちらも、適切な判断基準にはなりません。リスクの高い変更では、誰が要件を承認し、誰が実装を検査し、誰が本番投入を許可するかを記録します。リスクの低い補助作業では、必要な確認を省くのではなく、確認項目を簡潔にして開発速度との釣り合いを取ります。
よくある質問
AIが生成したコードは、そのまま本番へ使えますか?
出力を確認せずに本番へ反映する運用は避けてください。要件との一致、既存の設計や規約、テスト結果、セキュリティ、依存関係を担当者が確認し、通常の変更と同じリリース基準を満たしたものを採用します。エージェントが作成した変更も、所有者と承認者を決めてください。
社内のソースコードをチャットに貼り付けてもよいですか?
利用しているサービスのデータ取扱条件と、会社が承認した設定を確認してから判断します。秘密情報や個人データは、許可のないサービスや設定へ入力しないでください。対象コードを渡す必要がある場合は、権限のある管理担当者に利用可否を相談し、必要な範囲へ絞ります。
生成AIに作らせたテストが通れば、品質確認は十分ですか?
十分とは限りません。テストが仕様や実装の誤りをそのまま前提にしていると、誤った結果を正解として扱うことがあります。受け入れ条件を先に定め、独立した期待値、回帰試験、統合試験などを組み合わせ、対象環境で実行してください。
AIの提案に含まれる新しいライブラリはどう確認しますか?
公式レジストリで実在性と配布元を調べ、保守状況、脆弱性、採用バージョン、ライセンスがプロジェクトの方針に合うかを確認します。導入後はロックファイルと依存管理の記録を更新し、不要な依存を残さないようにします。
まとめ
生成AIコーディング支援は、補完、チャット、コードベース検索、編集・テスト、エージェントやレビューなどの機能を使い分けることで、調査や反復作業を進めやすくします。提案の正しさや業務への適合は自動で保証されないため、要件、差分、テスト、依存関係を人が確認する工程を保ちます。機密データを渡す条件、エージェントの権限、レビューの責任者を利用前に定め、小さな対象から効果と手戻りを測れば、便利さと管理の両方を保ちながら活用を広げられます。