





この記事で分かること
- AIシステムエンジニアが担う仕事と、AIエンジニアなど周辺職種との違い
- 企画、データ・モデル連携、評価、運用・改善、関係者調整それぞれの具体的な作業
- 技術、業務理解、コミュニケーションの三つに分けた必要スキル
- 生成AIによる開発工程の変化と、将来に向けて伸ばしたい能力
- 学習やキャリア形成で、実務に結び付く経験を作る方法
AIシステムエンジニアとは
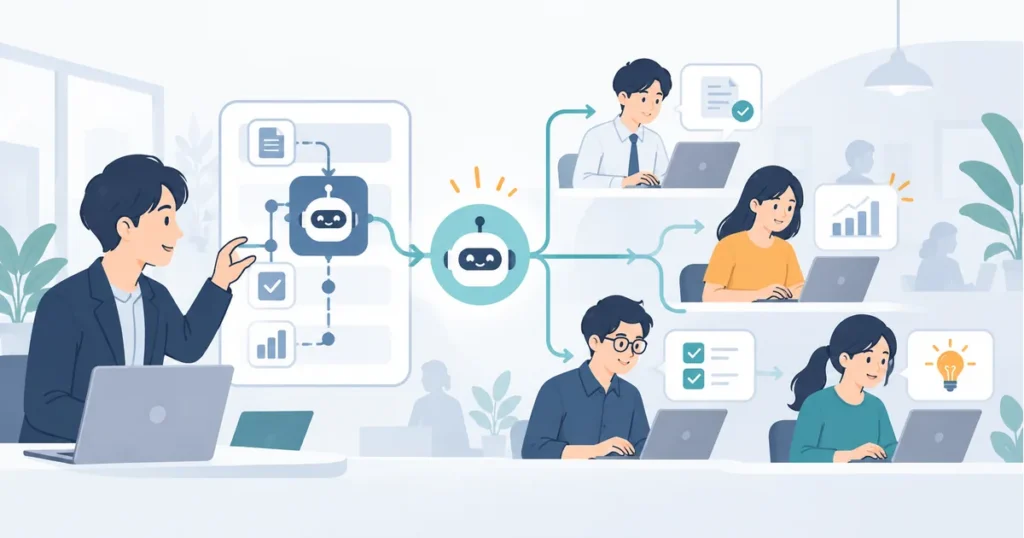
AIシステムエンジニアは、AIを業務やサービスの中で機能させるため、システム全体を設計・開発・運用する技術者です。モデルの精度だけを追うのではなく、どの業務のどの判断を支援するのか、何を入力として受け取り、どんな結果を返し、結果を誰がどう使うのかまでを考えます。
たとえば、問い合わせ対応を支援する仕組みなら、利用者の質問を受け取る画面、社内文書の検索、回答を生成するモデル、回答に使った情報の表示、担当者への引き継ぎ、利用状況の記録が一体となって動きます。AIシステムエンジニアは、それぞれの部品を選び、つなぎ、想定外の入力や障害にも対応できる形に整えます。
「AIシステムエンジニア」という肩書きの担当範囲は、企業やプロジェクトで違います。機械学習モデルの設計に深く関わる人もいれば、クラウド基盤や業務アプリとの連携を主に担当する人もいます。公的な職業情報で紹介されるAIエンジニアは、機械学習を用いた研究開発を中心に説明されています。一方、実務ではAIを組み込むソフトウェア開発、データ整備、業務設計、セキュリティや運用の役割が組み合わさるため、求人票では肩書きよりも担当工程と責任範囲を確認することが大切です。
| 役割の例 | 主に考えること | AIシステムエンジニアとの関係 |
|---|---|---|
| 機械学習エンジニア | 学習データ、モデルの構築や調整、推論処理 | モデルの実装や評価で協働し、チームによっては同じ担当者が担う |
| データサイエンティスト | データ分析、仮説の検証、分析結果の解釈 | 分析結果を実務システムへ接続し、継続利用につなげる |
| ソフトウェアエンジニア | アプリケーション、API、基盤、品質や保守性 | AIの入出力を既存機能や業務画面と統合する |
| AIシステムエンジニア | 課題から本番利用までの仕組み全体 | 必要な専門家と連携し、AIを業務で使えるシステムとして成立させる |
これらの役割は明確に分かれるとは限りません。小規模な開発では一人が複数の役割を兼ね、大規模な開発ではデータ、モデル、アプリ、基盤、セキュリティ、業務設計を複数人で分担します。AIを含む開発では「誰がどこまで判断し、運用後の問題を誰が直すか」を先に決めておくことも、技術設計と同じくらい重要です。
AIシステムエンジニアの仕事内容
仕事は、モデルを選ぶ前から始まります。AIを使う必要があるのかを確かめ、データを利用できる状態にし、性能を測る条件を決め、利用者が困らない形で本番へつなぐ必要があります。実際の工程は往復することも多く、評価で見つかった問題から要件やデータ設計へ戻ることもあります。
企画・要件定義で解く課題を決める

最初に行うのは、AIを導入すること自体ではなく、改善したい業務を具体化することです。現場の作業を観察したり、担当者へ聞き取りをしたりして、時間がかかる工程、判断に迷いやすい箇所、処理量の増加が課題になっている場面を整理します。課題が曖昧なまま「AIで効率化したい」と進めると、導入後に何をもって成果とするか決められません。
次に、AIに任せる範囲と人が確認する範囲を決めます。たとえば、AIが候補を提示し、最終判断は担当者が行うのか、一定の条件を満たした処理は自動で進めるのかで、必要な画面、記録、確認手順、例外対応が変わります。削減したい作業時間だけでなく、誤判定の影響、回答待ち時間、再作業の量、利用者の受け入れやすさなど、業務上の成果を測る指標も定めます。
要件定義では、利用者、利用頻度、扱うデータ、既存システムとの接続、性能や応答速度、アクセス権、監査用の記録、障害時の代替手順を確認します。扱う情報に個人情報や機密情報が含まれる場合は、利用目的や保管、閲覧範囲、外部サービスへの送信可否を関係部門と確認します。精度目標だけでなく、精度が届かない場合に業務をどう続けるかまで決めておく必要があります。
課題、入力、出力、評価基準、責任範囲を先に整理する手順は、AIシステム開発の要件定義|精度・データ・責任範囲の決め方でも確認できます。初期段階では、AIを使わず検索やルールの見直しで解決できる可能性も比較し、費用やリスクに見合う方法を選びます。
データとモデルを既存システムにつなぐ
AIの出力は、入力データや周辺システムの設計に左右されます。エンジニアは、データの所在、形式、更新頻度、欠損や重複、利用権限、品質を確認し、AIが参照できるように収集・変換・保管の流れを作ります。学習型モデルでは、正解ラベルの付け方やデータ分割の妥当性も検討します。生成AIを社内情報と組み合わせる場合は、文書の更新、検索範囲、利用者ごとのアクセス制御、回答の根拠をどのように扱うかが設計上の論点です。
モデルの選択では、正答率だけでなく、処理時間、費用、データ保護、導入先の環境、モデル更新時の互換性、利用条件などを比べます。既存のAIサービスを利用する方法、公開モデルを自社環境で動かす方法、自社データで追加学習する方法などは、目的と制約によって適否が変わります。大きなモデルほど常に最適とは限らず、単純な分類や検索、既存の業務ルールで十分な場合もあります。
そのうえで、AIと業務アプリの間にAPIなどの接続を設け、入力の検査、タイムアウト、再試行、エラー処理、権限確認を実装します。AIが応答しないときに利用者へ何を表示するか、古い情報や不正な形式の結果をどう扱うかも決めます。AIの応答が確率的である場合、同じ入力に対して常に同じ出力になると仮定した作りは避け、出力の検査と利用者への説明を加えます。
こうしたデータ整備やチームづくりを自社で進める場合は、AIシステム開発を内製化する方法|必要な人材・体制・進め方のように、必要な役割と外部パートナーとの分担を検討します。システムエンジニアは、自分だけですべての専門領域を抱えるのではなく、データサイエンティスト、インフラ担当、業務担当者などと設計をすり合わせます。
評価・テストで利用条件を確認する
開発したAIが「それらしい答え」を出すことと、実務で必要な品質を満たすことは別です。評価では、本番で起こり得る入力を集め、目的に合う観点で性能を測ります。分類や予測なら正解率、適合率、再現率などを用途に応じて確認し、生成AIなら情報の正確さ、根拠との一致、回答不能時の振る舞い、指示への追従、安全性、応答時間などを調べます。単一の点数だけに頼ると、特定の条件で起きる失敗を見落とすことがあります。
テストデータは、開発中に使ったデータと分け、偏りや代表性を確認します。例外的な入力、表記ゆれ、誤字、欠けた情報、想定外の質問を含むケースを用意し、どのような誤りが重大なのかを業務担当者と分類します。誤答が許容できない業務では、自動化の範囲を狭め、人の確認へ回す条件を設計します。必要に応じて、業務部門によるレビューやセキュリティ検査も行います。
テスト結果は、精度の数値だけでなく、失敗例、発生条件、業務への影響、修正方針を記録します。改善によって別のケースの性能が落ちないか、変更前後の比較も必要です。最終的には、どの条件なら導入できるか、どのケースは人が引き取るか、運用中にどの指標を監視するかを関係者と合意します。
本番運用を設計して継続的に改善する

システムはリリースして終わりではありません。本番環境では、データの傾向や業務ルール、利用者の質問が変化し、以前は適切だったモデルや検索結果が合わなくなることがあります。エンジニアは、エラー、応答時間、利用量、費用、品質に関する指標を継続して把握し、異常が起きた際に原因を調べられるログや履歴を整えます。AIがどのデータやモデルの版を使ったのかを追跡できれば、問題の再現や切り戻しも行いやすくなります。
運用設計には、モデルやプロンプトの変更手順、段階的なリリース、利用者への告知、障害時の連絡先、手動運用への切り替えも含まれます。生成AIを使う場合は、想定外の回答や不適切な出力を報告する経路を用意し、必要に応じて人が確認できる仕組みを設けます。ログを取る際は、調査に必要な情報と、個人情報や機密情報を過剰に保存しない方針の両方を考えます。
運用データや現場からの声を分析し、検索対象を更新する、入力画面を変える、モデルや指示を調整する、業務ルールを見直すといった改善につなげます。変更を行う際は再度テストし、品質や安全性が保たれていることを確認してから反映します。監視、評価、改善を一続きの工程として扱うことが、AIシステムを安定して使い続ける基本です。
関係者の認識をそろえて導入を支える
AIシステムの品質は、エンジニアの実装だけでは決まりません。業務担当者は例外や判断の背景を知り、情報システム部門は既存環境や権限を管理し、法務・セキュリティ部門は契約や情報管理を確認します。開発会社やクラウド事業者が関わる場合は、データの管理、障害対応、変更作業、問い合わせ窓口の責任も共有する必要があります。
エンジニアには、専門用語を業務上の判断に置き換えて説明する役割があります。「モデル精度が何%」という報告だけでなく、どの条件で間違えやすいのか、失敗したときに顧客や担当者へどんな影響が出るのか、どの確認策でリスクを抑えるのかを伝えます。性能、費用、納期、安全性の間にトレードオフがある場合は、選択肢と影響を示し、決定事項を記録します。
導入後の定着までを考え、利用者への説明、操作方法、フィードバックの収集、問い合わせ対応も計画します。利用されない原因が画面や手順にあるのか、回答品質にあるのか、業務分担にあるのかを切り分け、関係者と改善します。AI機能の導入だけで業務が変わるわけではないため、運用ルールや教育を整えるところまで支援することが重要です。
AIを導入した後も現場で使われる条件は、「AIを入れたのに使われない」を防ぐシステム開発の進め方でも扱っています。生成AIを開発工程へ取り入れる場合の役割分担や注意点は、生成AIでシステム開発はどこまで変わる?工程別活用ガイドも参考になります。
AIシステムエンジニアに必要なスキル
必要な力は、特定のAIライブラリや流行のサービスを知っていることだけではありません。担当する工程によって技術の深さは違いますが、システムとして実現し、業務で役立つ状態を保つための基礎を組み合わせて身につけます。
技術スキル:開発・データ・評価・運用をつなぐ
- プログラミングとソフトウェア設計:Pythonなどを使って処理を実装し、テストしやすく変更しやすい構成にします。API連携、データベース、例外処理、バージョン管理の基本も役立ちます。
- データ処理と統計の基礎:SQLやデータ加工に慣れ、欠損値、偏り、分布の変化を読み取ります。統計的な指標が何を示し、どこで誤解を招くかを理解します。
- 機械学習・生成AIの仕組み:学習、推論、過学習、分類や回帰の評価、生成モデルの特徴を押さえます。モデルの得意不得意を知り、業務に合う方法を選ぶ判断力が必要です。
- システム基盤とセキュリティ:クラウドやネットワーク、認証・認可、暗号化、監視、バックアップの基礎を身につけます。データやモデルを安全に扱い、障害時に復旧できる構成を検討します。
- 品質評価と運用:テストデータ、評価指標、ログ、トレース、アラート、リリース管理を設計します。モデルの変更前後で性能を比較し、問題が起きたときに調査できる状態を作ります。
AIの技術は更新が続くため、特定製品の画面操作だけを覚えるのではなく、データの流れ、品質評価、権限管理、障害対応といった共通の考え方を学び、使う技術ごとの差分を追う姿勢が有効です。
業務スキル:現場の課題と成果を捉える
業務の流れや用語を理解し、誰がどの判断を行うかを図にできると、AIを適切な場所に置きやすくなります。現場へのヒアリングでは、理想の手順だけでなく、繁忙期や例外処理、引き継ぎ、二重入力などの実態も確認します。データがどう作られ、誰が更新し、どんな理由で誤りが起きるかを知ることも、モデル選定と評価に欠かせません。
費用対効果や導入後の成果を考える際は、作業時間、処理件数、修正率、待ち時間など業務に合った指標を使います。短期的な導入費だけでなく、運用担当者、クラウド利用料、データ整備、再学習、問い合わせ対応などの継続費用も検討します。法務、個人情報保護、知的財産、社内規程に関する論点は専門部署と確認し、技術者だけで結論を出さないことが大切です。
コミュニケーションスキル:技術判断を共有する
AI開発は複数の専門職が協力して進めます。ヒアリング、要件整理、設計レビュー、進捗共有、障害報告などで、相手が判断できる材料を簡潔に示す力が欠かせません。曖昧な要望をそのまま仕様にせず、「誰が、何を入力し、どの出力を見て、次に何をするのか」と質問し、共通理解を作ります。
また、AIの限界や不確実性を隠さず説明する姿勢も重要です。期待通りに動かないケースを共有し、確実にできること、追加検証が必要なこと、現時点では人の判断を残すことを分けて伝えます。異なる意見を取りまとめ、合意した判断や未解決の点を記録する力は、品質事故の予防や引き継ぎにもつながります。
生成AIで仕事内容はどう変わるか
生成AIは、コードやテスト案、設計文書の下書き、ログの要約、調査の補助など、開発作業の一部を速める道具として使われています。作業の速度が上がっても、出力が要件に合うか、既存の設計と矛盾しないか、セキュリティ上の問題がないかを確かめる責任は残ります。作ったものの量より、何を解決するために作り、どの基準で正しさを確認したかが重視されます。
下書きの活用から検証・設計へ比重が移る

生成AIへ簡単な処理やテストコードを書かせることはできますが、出力が正しいとは限りません。仕様の読み違い、存在しないAPI、誤った前提、危険な入力処理が混ざる可能性があります。エンジニアは、生成されたコードを理解し、テストを通し、既存システムに合うよう修正し、必要なレビューを受けてから使います。入力に機密情報を含めてよいか、利用サービスが何を保存するかも、会社のルールと契約に照らして確認します。
一方、AIシステムを作る場面では、モデルの呼び出しを実装するだけでは価値になりません。どのデータを参照させるか、誤答時にどう止めるか、利用者が根拠を確かめられるか、運用中の品質をどう測るかなど、システム全体の設計力が必要です。開発者が反復作業をAIに支援させるほど、要件、アーキテクチャ、セキュリティ、評価、運用をつなぐ判断がより重要になります。
また、AIの利用方法やモデルの機能は変わり続けます。新しいツールを試す際は、性能だけでなく、データの扱い、利用条件、切り替えやすさ、監視方法を確認し、小さく試してから業務へ広げます。流行語や製品名を追うだけではなく、利用者の課題と運用条件に基づいて選択することが、長く役立つ力です。
AIシステムエンジニアの将来性
将来性を一言で「需要が伸びる」と断定するのは適切ではありません。AIが普及する速さ、業務へ組み込む企業の数、データの整備状況、規制や契約、品質事故への対応によって、求められる職務や採用は変わります。公的な職業情報ではAIエンジニアの需要を高いと説明する一方、同じ説明の中で法的・倫理的な論点が働き方に影響し得ることにも触れています。さらに、その職種説明は機械学習エンジニアを中心にしており、AIシステムエンジニア全体の採用数を直接予測したものではありません。
モデルを作る力に、実装と運用の力が加わる
AIを業務で使う企業が増えるほど、データの準備、既存システムとの連携、出力の評価、権限や情報管理、本番後の監視を担う仕事が必要になります。近年の公的なスキル標準も、データマネジメントの役割を独立して示し、AI実装・運用やガバナンスに関するスキルを含めています。これは、モデル開発だけでなく、データの品質と信頼性を保ち、継続運用へつなぐ能力が組織の人材育成で扱われていることを示します。
そのため、モデルを一から研究開発する仕事だけがキャリアの選択肢ではありません。業務アプリにAIを組み込む、データ基盤を整える、AIのテストと監視を自動化する、導入プロジェクトの要件や品質を管理する、利用者が安全に使えるルールを設計するなど、技術と業務を結ぶ領域で専門性を深められます。開発の自動化が進んでも、目的の確認、影響の判断、設計上の責任、関係者への説明は残ります。
雇用見通しは職種名だけで判断しない
国の就業構造推計は、一定の経済・産業・労働参加などの前提を置いた将来シナリオです。そこで使われる「AI・ロボット等の利活用を担う人材」という分類は、AIシステムエンジニアだけを切り出した求人予測ではありません。厚生労働省の職業能力開発に関する計画も、AIなどで定型タスクの効率化が進む可能性と、職種間の人材ミスマッチやデジタル人材育成の必要性を述べています。これらから個人の採用機会や将来の給与をそのまま推定することはできません。
実際の募集では、同じ「AIエンジニア」という名前でも、機械学習の研究、業務システム開発、クラウド基盤、生成AIアプリ、データ分析など内容が異なります。求人票では、使う技術だけでなく、企画や要件定義に参加するか、本番運用の責任を持つか、利用者や顧客と直接話すか、評価指標を設計するかを読みます。需要の数字だけを見るよりも、担当したい工程で必要な経験と、企業が実際に任せる責任範囲を確かめるほうが、キャリアの選択に役立ちます。
将来に備えて伸ばしたい能力
- 変化に適応する力:新しいモデルや開発環境を実際の要件に照らして検証し、適用する理由と見送る理由を説明できるようにします。
- データの品質と管理:データの出どころ、権限、更新、品質、保管方法を理解し、利用ルールを設計・運用します。
- 評価と安全性:性能や応答品質を測るだけでなく、失敗時の影響、プライバシー、セキュリティ、人の確認が必要な条件を考えます。
- 業務と技術の翻訳:現場の要望を検証可能な要件に変え、技術上の制約を意思決定者にわかる言葉で伝えます。
- 継続的な学習:実装後のログや利用者の声から改善点を見つけ、変更と再評価を繰り返せるようにします。
これらは、AIを使うかどうかにかかわらず、信頼できるソフトウェアを作り運用するための基礎でもあります。技術の流行が変わっても、課題設定、データ品質、システム設計、検証、説明責任を組み合わせて価値を作る経験は、複数の職種や業界に活かせます。
未経験から目指すための学び方
未経験から進む場合は、AIの数式や最新モデルを一度に学ぶより、小さなシステムを作り、データから運用までの流れを体験する方法が現実的です。すでにソフトウェア開発、データ分析、業務運用、クラウド管理などの経験があれば、その強みをAIと結び付ける領域から始められます。
- プログラミングとデータ処理を身につける:Python、SQL、HTTP API、Gitの基本を学び、データを読み込み、加工し、結果を返す小さなアプリを作ります。
- AIの基礎と評価を学ぶ:機械学習の基本用語や生成AIの特性を理解し、何を正解とするのか、どんな入力で失敗するのかを確かめるテストを用意します。
- 業務課題を題材にする:身近な作業を選び、利用者、入力、出力、成功条件、失敗時の対応を文章や図にまとめます。実データを使う場合は権限と個人情報に注意し、許可のない機密情報を外部サービスへ送らないようにします。
- 運用まで作る:エラー処理、ログ、アクセス制御、操作方法、更新手順を加え、他の人が使ったときのフィードバックを受けて改善します。
- 経験を説明可能にする:選んだ方法、評価データ、失敗した例、対策、残る制約を記録し、なぜその設計にしたかを説明できるポートフォリオにします。
資格は知識を体系的に学ぶ目標にはなりますが、実務で必要なすべての能力を示すものではありません。採用では、成果物の品質に加えて、要件をどう整理したか、評価の限界をどう説明したか、チームでどのように進めたかを話せることが役立ちます。担当領域に応じて、情報処理、クラウド、データ分析、セキュリティなどの学習を組み合わせましょう。
AIシステムエンジニアに関するよくある質問
AIシステムエンジニアは、AIモデルを自分で開発する必要がありますか?
必ずしもモデルを一から開発する必要はありません。既存モデルやAIサービスを活用し、業務データや既存システムと連携させ、評価と運用を設計する仕事もあります。ただし、モデルの特徴や限界を理解し、目的に合う方法を選べる基礎知識は必要です。
数学や統計が苦手でも目指せますか?
担当領域によって必要な深さは異なります。機械学習モデルを研究・開発する場合は統計や線形代数などをより深く使いますが、業務アプリとの連携や運用を中心にする場合は、評価指標を読み、データの傾向や限界を理解する実務的な基礎から始められます。自分が担いたい工程に合わせて学習範囲を広げるとよいでしょう。
プログラミング未経験からでも転職できますか?
可能性はありますが、学習だけで採用を保証することはできません。プログラミング、データ処理、API、テストの基礎を身につけ、小さくても要件整理から運用まで説明できる成果物を作ることが現実的です。業務知識や顧客対応の経験がある人は、その分野の課題をAIでどう支援するかを示すと強みになります。
将来はAIだけに詳しい専門家でなければ活躍できませんか?
その必要はありません。AI・データの専門性に加えて、ソフトウェア開発、クラウド、セキュリティ、業務分析、プロジェクト推進などを組み合わせた役割があります。大切なのは、担当する仕事で必要な深さを見極め、周辺領域の専門家と協力できることです。
AIシステムの将来性を判断するとき、何を確認すればよいですか?
職種名だけで判断せず、求人や職務内容に記載された工程、技術、運用責任、顧客との調整範囲を確認します。業界や会社ごとの差があるため、採用数を一つの予測値で決めつけるより、どの課題を解き、どんな品質や安全性を任される仕事なのかを見ることが重要です。
まとめ
AIシステムエンジニアは、業務課題の整理からデータ・モデル連携、評価、本番運用、継続改善までをつなぐ職種です。技術力に加え、現場の業務を理解し、AIの限界やリスクを関係者へ説明する力が求められます。生成AIによって一部の下書き作業は支援されても、正しさを確かめ、業務に適したシステムを設計し、運用の責任を果たす役割は残ります。将来性は職種名だけでは判断できないため、希望する工程に必要なスキルを積み、実装と評価、運用を経験していくことが重要です。
自社の業務にAIが適するか、既存システムとの連携や導入後の運用をどう設計するかを整理したい場合は、課題や制約を洗い出したうえで開発方法を検討します。現状把握から相談を始めることもできます。